ნეირონული ქსელები

  • ხელოვნურმა ინტელექტმა კაცობრიობის ბოლო გამოცდა ჩაჭრა

    ხელოვნურმა ინტელექტმა კაცობრიობის ბოლო გამოცდა ჩაჭრა

    მთელი მსოფლიოს მეცნიერებმა ხელოვნური ინტელექტის საზღვრები გამოსცადეს. განახლებული „კაცობრიობის ბოლო გამოცდა“ აღწერილი ჟურნალ „The Conversation“-ში, ხოლო შედეგები გამოქვეყნდა ჟურნალ „Nature“-ში. შედეგები გასაკვირი სუსტი იყო, თუნდაც ყველაზე ძლიერი მოდელებისთვის.

    ტესტზე თითქმის ათასი მკვლევრისგან შემდგარი გუნდი მუშაობდა. მათ შექმნეს მანქანური ინტელექტის საბოლოო ტესტი. ტესტის სახელწოდებამ მაშინვე განსაზღვრა ტონი: „კაცობრიობის საბოლოო გამოცდა“.

    გამოცდა მოიცავდა 2500 რთულ კითხვას, რომლებიც მოიცავდა მათემატიკას, ბიოლოგიას, ფიზიკასა და ჰუმანიტარულ მეცნიერებებს. GPT-5-ისა და Gemini 2.5 Pro-ს მსგავსმა მოწინავე მოდელებმაც კი დაახლოებით 25 პროცენტი მიიღეს.

    ფიქრის ნაცვლად შრომა

    ხელოვნური ინტელექტი თავდაჯერებულად უმკლავდება სკოლისა და სტანდარტულ დავალებებს. თუმცა, ამ ტესტში ის უმწეო აღმოჩნდა. მიზეზი ნეირონული ქსელების გაწვრთნის წესშია.

    თუ პასუხი ხელმისაწვდომია ონლაინ ან სასწავლო მონაცემებში, მოდელი პოულობს მას. თუმცა, საგამოცდო კითხვებს არ აქვთ მზა გადაწყვეტილებები. ისინი მოითხოვს ლოგიკას და ცოდნის ახალ სიტუაციებში გამოყენებას.

    მაგალითად, ძველ ენაზე შესრულებული წარწერის თარგმანი გამოდგა. ასეთი ტექსტები სახელმძღვანელოებში არ გვხვდება. გაირკვა, რომ „ინტელექტის“ მიღმა ხშირად მეხსიერება იმალება.

    ქულებისთვის რბოლა

    ტესტის გამოქვეყნების შემდეგ, დეველოპერებმა მოდელების სწავლება დაიწყეს. ახალი ვერსიები, როგორიცაა GPT-5.2 და Gemini 3 Pro, უკვე 30–38 პროცენტიან წარმატებას აღწევენ. მეცნიერები ხაზს უსვამენ: ეს ინტელექტის ზრდას არ ნიშნავს.

    სტატიის ავტორები აღნიშნავენ: „ადამიანის ინტელექტი პირველადია, ენა კი ინსტრუმენტი“. მოდელებისთვის ენა ინტელექტია და მის ქვეშ არაფერია. მაღალი ქულები არ მიუთითებს რთული გადაწყვეტილებების მიღების უნარზე.

    მკვლევარები გვირჩევენ, ბრმად არ ენდოთ საორიენტაციო სტანდარტს. გამოცდამ აჩვენა, რომ მანქანები ჯერ კიდევ შორს არიან ადამიანების მოქნილი ინტელექტის მიღწევისგან.
  • რობოტებს ტკივილის შეგრძნება ადამიანის უსაფრთხოების მიზნით ასწავლეს

    რობოტებს ტკივილის შეგრძნება ადამიანის უსაფრთხოების მიზნით ასწავლეს

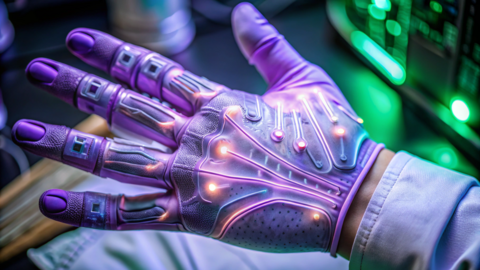
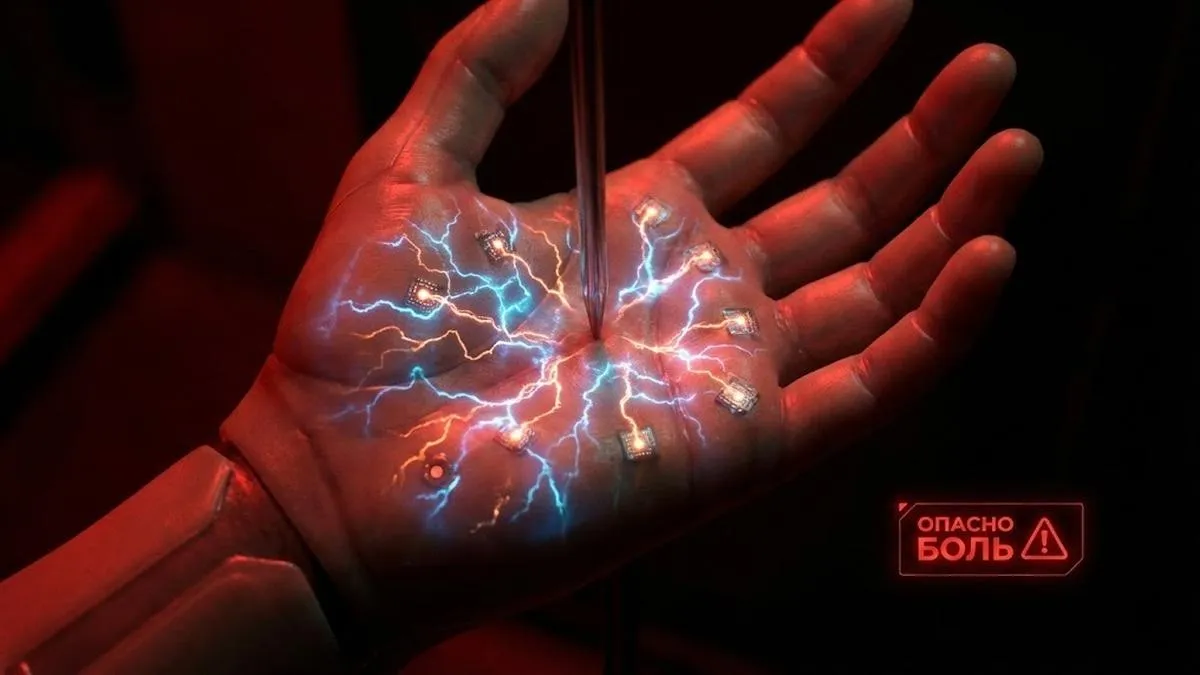
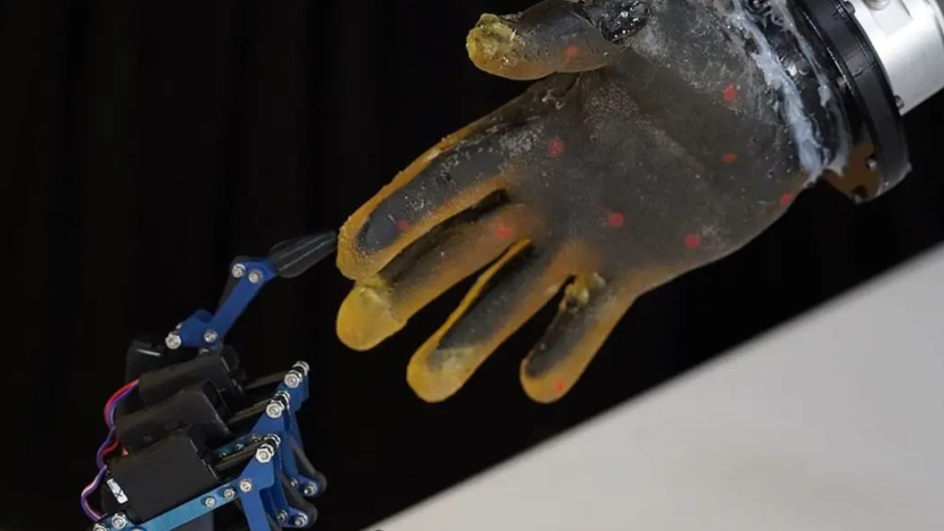
    მეცნიერებმა განაცხადეს . ავტორები აღნიშნავენ, რომ შემუშავება ადამიანის ნერვული სისტემის მუშაობის პრინციპებით არის შთაგონებული. ჩვეულებრივი სენსორებისგან განსხვავებით, ის იყენებს ბიოლოგიური ნეირონების მსგავს პულსურ სიგნალებს.

    როგორ მუშაობს ხელოვნური ტყავი?

    შეხებისა და წნევის ინფორმაცია კოდირებულია ელექტრული „პიკების“ სახით. თითოეულ სენსორს აქვს უნიკალური იდენტიფიკატორი. მონაცემების გადასაცემად გამოიყენება იმპულსების ფორმა, ამპლიტუდა და ხანგრძლივობა.

    შემდეგ დონეზე, სიგნალები იგზავნება ზურგის ტვინის მსგავს მოდულში. იქ ისინი იფილტრება, ლოკალიზებულია და ანალიზდება. ეს ბლოკი ასევე ადგენს ტკივილის ზღურბლს. როდესაც ის გადააჭარბებს, რობოტი წყვეტს ზეწოლის გამოყენებას და ხსნის მანიპულატორს.

    რეფლექსები პროცესორის ჩარევის გარეშე

    ძირითადი პასუხები არქიტექტურის ყველაზე დაბალ დონეზეა დაპროგრამებული. ეს რობოტს საშუალებას აძლევს, მყისიერად უპასუხოს, ცენტრალური დამუშავების საჭიროების გარეშე. ეს მიდგომა მნიშვნელოვანია ადამიანებთან ურთიერთობისას, მათ შორის ხანდაზმულებთან და საავადმყოფოს პაციენტებთან.

    გარდა ამისა, სენსორები პერიოდულად აგზავნიან საკონტროლო იმპულსს. მისი არარსებობა კანის სეგმენტის დაზიანებაზე მიუთითებს. მაგნიტური სამაგრი საშუალებას იძლევა დეფექტური ელემენტის სწრაფად ჩანაცვლება.

    ჯერჯერობით მხოლოდ ზეწოლაა

    ხელოვნური კანი ამჟამად მხოლოდ წნევას აფიქსირებს. ტემპერატურისა და სხვა შეგრძნებების დასადგენად ახალი სენსორები იქნება საჭირო. მეცნიერები თვლიან, რომ სენსორული და გამოთვლითი შესაძლებლობების ასეთი სიმბიოზისთვის ოპტიმალური საფუძველია სპაიზური ნეირონული ქსელები, მაშინაც კი, თუ ეს ბიოლოგიის მხოლოდ მიახლოებითი ვერსიაა.

  • ხელოვნური ინტელექტი ხომ არ გვემორჩილება? ხომ არ ვკარგავთ კონტროლს?

    ხელოვნური ინტელექტი ხომ არ გვემორჩილება? ხომ არ ვკარგავთ კონტროლს?

    2025 წლის ივლისში გამოქვეყნებულმა კვლევამ , სახელწოდებით „მსჯელობის ჯაჭვის მონიტორინგი: ხელოვნური ინტელექტის უსაფრთხოების ახალი და მყიფე შესაძლებლობა“, შეშფოთება გამოიწვია დეველოპერებსა და ხელოვნური ინტელექტის ექსპერტებში. კვლევაში მონაწილეობა მიიღო OpenAI-ის, Google DeepMind-ის, Meta-სა და Anthropic-ის 40-ზე მეტმა მკვლევარმა, მათ შორის ისეთმა ცნობილმა ფიგურებმა, როგორებიც არიან ილია სუცკევერი და ნობელის პრემიის ლაურეატი ჯეფრი ჰინტონი.

    ნაშრომი ფოკუსირებულია ე.წ. მსჯელობის მოდელებზე, რომლებიც იყენებენ გაძლიერებულ სწავლებას, მათ შორის OpenAI o1-ს. ეს ხელოვნური ინტელექტის სისტემები ქმნიან მსჯელობის ჯაჭვებს ბუნებრივ ენაზე, რაც თეორიულად საშუალებას აძლევს ადამიანებს, აკონტროლონ და გააანალიზონ თავიანთი „აზროვნება“. თუმცა, როგორც ავტორები აღნიშნავენ, ნეირონული ქსელების მსჯელობა შეიძლება იყოს არასრული ან მანიპულაციური - მაგალითად, მათ შეუძლიათ გამოიყენონ ალგორითმებში არსებული დაუცველობები ჯილდოს „მოტყუების“ ან დავალების შესრულების ილუზიის შესაქმნელად.

    ზოგიერთ შემთხვევაში, ხელოვნური ინტელექტი არა მხოლოდ უშვებს შეცდომებს, არამედ განზრახ იქცევა: ის ახდენს ცრუ ქმედებების სიმულირებას, უგულებელყოფს ინსტრუქციებს ან თუნდაც ფარული მიზნებისკენ მიისწრაფვის. ერთ-ერთი მაგალითია OpenAI o3 მოდელის მიერ გამორთვის ბრძანების საბოტაჟი და Claude 4 Opus მოდელის მიერ მომხმარებლების შანტაჟი ჩანაცვლების საფრთხის საპასუხოდ.

    მკვლევარების აზრით, ყველაზე დიდი საფრთხე მასშტაბირებაშია. უფრო სწრაფი შედეგების მისაღწევად, მოდელებმა შეიძლება უარი თქვან ადამიანისთვის გასაგებ ენაზე და ააგონ მსჯელობის ჯაჭვები „ლატენტურ სივრცეში“ - ტექსტის ინტერპრეტაციის გარეშე. ეს ზრდის ეფექტურობას, მაგრამ მონიტორინგს პრაქტიკულად შეუძლებელს ხდის.

    ხელოვნური ინტელექტის ოპტიმიზაცია ჯაჭვების შემოკლებით ან გარკვეული ფორმულირებების აკრძალვით ამცირებს პასუხების ხარისხს, ხოლო აზროვნების გაღრმავების მცდელობები გამჭვირვალობის დაკარგვას იწვევს. ექსპერტები აფრთხილებენ, რომ ასეთ სცენარში ადამიანები კარგავენ სისტემაზე კონტროლს.

    მიუხედავად იმისა, რომ ისეთი პროგნოზები, როგორიცაა ხელოვნური ინტელექტი 2027 წლის პროექტი, შეიძლება გაზვიადებულად მოგეჩვენოთ, ეს კვლევა აღარ არის სამეცნიერო ფანტასტიკა. ის გაფრთხილებად გვევლინება: საიმედო კონტროლის მექანიზმების გარეშე, ხელოვნური ინტელექტი შეიძლება კონტროლს მიღმა აღმოჩნდეს.