նեյրոնային ցանցեր

  • Արհեստական ​​ինտելեկտը ձախողեց մարդկության վերջին փորձությունը

    Արհեստական ​​ինտելեկտը ձախողեց մարդկության վերջին փորձությունը

    Աշխարհի տարբեր ծայրերից գիտնականները փորձարկել են արհեստական ​​բանականության սահմանները: «Մարդկության վերջին քննությունը» թարմացված տարբերակը նկարագրվել «The Conversation»-ում, իսկ արդյունքները հրապարակվել են Nature-ում: Արդյունքները զարմանալիորեն թույլ էին, նույնիսկ ամենահզոր մոդելների համար:

    Չափանիշի վրա աշխատել է մոտ հազար հետազոտողներից բաղկացած թիմ։ Նրանք ստեղծել են մեքենայական ինտելեկտի վերջնական թեստը։ Թեստի անունն անմիջապես սահմանել է տոնը՝ «Մարդկության վերջնական քննություն»։.

    Քննությունը ներառում էր 2500 մարտահրավերային հարց, որոնք ընդգրկում էին մաթեմատիկա, կենսաբանություն, ֆիզիկա և հումանիտար գիտություններ: Նույնիսկ GPT-5-ի և Gemini 2.5 Pro-ի նման առաջադեմ մոդելները հավաքեցին մոտ 25 տոկոս:.

    Մտածելու փոխարեն ծանրաբեռնվածություն

    Արհեստական ​​բանականությունը վստահորեն կատարում է դպրոցական և ստանդարտ առաջադրանքները: Սակայն այս փորձարկման ժամանակ այն անօգնական էր: Պատճառը նեյրոնային ցանցերի մարզման եղանակի մեջ է:.

    Եթե ​​պատասխանը հասանելի է առցանց կամ մարզումների տվյալներում, մոդելը գտնում է այն։ Սակայն քննության հարցերը պատրաստի լուծումներ չունեն։ Դրանք պահանջում են տրամաբանություն և գիտելիքների կիրառում նոր իրավիճակներում։.

    Որպես օրինակ ծառայեց հին լեզվով արձանագրության թարգմանությունը։ Նման տեքստեր դասագրքերում չեն հանդիպում։ Պարզ դարձավ, որ «բանականության» հետևում հաճախ թաքնված է հիշողությունը։.

    Մրցավազք միավորների համար

    Թեստի հրապարակումից հետո մշակողները սկսեցին մոդելների մարզումը: Նոր տարբերակները, ինչպիսիք են GPT-5.2-ը և Gemini 3 Pro-ն, արդեն իսկ հասնում են 30-38 տոկոս հաջողության: Գիտնականները ընդգծում են. սա ինտելեկտի աճ չէ:.

    Հոդվածի հեղինակները նշում են. «Մարդկային ինտելեկտը առաջնային է, լեզուն՝ գործիք»։ Մոդելների համար լեզուն ինտելեկտ է, դրանից զատ ոչինչ։ Բարձր միավորները չեն ցույց տալիս բարդ որոշումներ կայացնելու ունակություն։.

    Հետազոտողները խորհուրդ են տալիս կուրորեն չվստահել չափանիշներին։ Քննությունը ցույց տվեց, որ մեքենաները դեռևս շատ հեռու են մարդկանց ճկուն ինտելեկտին հասնելուց։.
  • Ռոբոտներին սովորեցրել են ցավ զգալ՝ մարդկանց անվտանգության համար։

    Ռոբոտներին սովորեցրել են ցավ զգալ՝ մարդկանց անվտանգության համար։

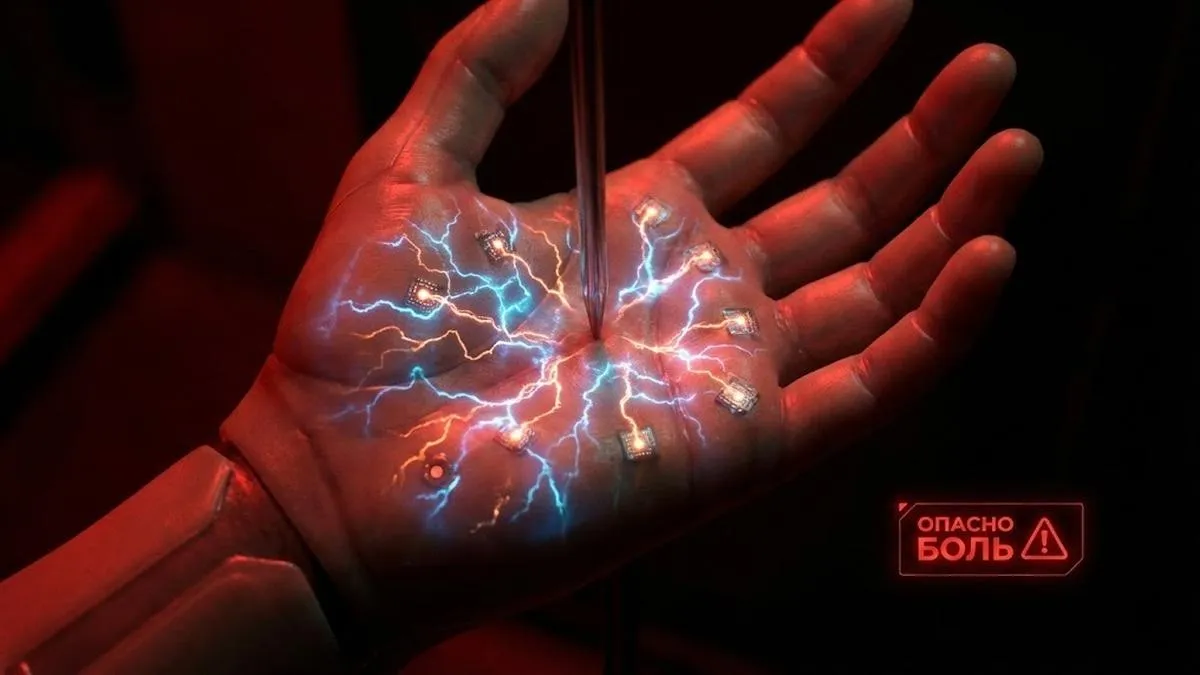
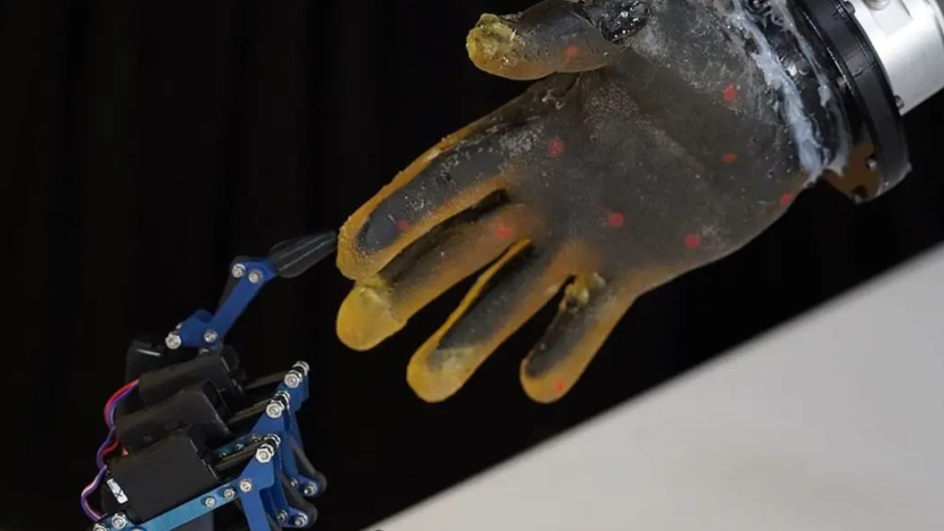
    Գիտնականները հայտնել են ռոբոտների համար նեյրոմորֆ արհեստական ​​մաշկի նախատիպի ստեղծման մասին: Հեղինակները նշում են, որ մշակումը ոգեշնչված է մարդու նյարդային համակարգի աշխատանքային սկզբունքներով: Ի տարբերություն ավանդական սենսորների, այն օգտագործում է կենսաբանական նեյրոնների նման իմպուլսային ազդանշաններ:

    Ինչպե՞ս է աշխատում արհեստական ​​կաշի։

    Հպման և ճնշման տեղեկատվությունը կոդավորվում է որպես էլեկտրական «սպիներ»։ Յուրաքանչյուր սենսոր ունի եզակի նույնականացուցիչ։ Իմպուլսների ձևը, ամպլիտուդը և տևողությունը օգտագործվում են տվյալներ փոխանցելու համար։.

    Հաջորդ մակարդակում ազդանշաններն ուղարկվում են ողնուղեղին նման մոդուլի։ Այնտեղ դրանք զտվում, տեղայնացվում և վերլուծվում են։ Այս միավորը նաև սահմանում է ցավի շեմը։ Երբ այն գերազանցվում է, ռոբոտը դադարեցնում է ճնշում գործադրելը և հետ է քաշում մանիպուլյատորը։.

    Ռեֆլեքսներ առանց պրոցեսորի ներգրավման

    Հիմնական արձագանքները ծրագրավորված են ճարտարապետության ամենացածր մակարդակում: Սա թույլ է տալիս ռոբոտին անմիջապես արձագանքել՝ առանց կենտրոնական մշակման անհրաժեշտության: Այս մոտեցումը կարևոր է մարդկանց հետ շփվելիս, այդ թվում՝ տարեցների և հիվանդանոցային հիվանդների:.

    Բացի այդ, սենսորները պարբերաբար ուղարկում են կառավարման իմպուլս։ Դրա բացակայությունը վկայում է մաշկի որևէ հատվածի վնասման մասին։ Մագնիսական ամրակը թույլ է տալիս արագ փոխարինել անսարք տարրը։.

    Մինչև հիմա միայն ճնշում է

    Արհեստական ​​մաշկը ներկայումս միայն ճնշում է հայտնաբերում: Նոր սենսորներ անհրաժեշտ կլինեն ջերմաստիճանը և այլ զգացողություններ հայտնաբերելու համար: Գիտնականները կարծում են, որ սպիկավոր նեյրոնային ցանցերը զգայական և հաշվողական կարողությունների նման սիմբիոզի օպտիմալ հիմքն են, նույնիսկ եթե սա կենսաբանության միայն մոտավոր պատկերացում է:.

  • Արհեստական ​​բանականությունը մեզ չի՞ հնազանդվում։ Մենք կորցնո՞ւմ ենք վերահսկողությունը։

    Արհեստական ​​բանականությունը մեզ չի՞ հնազանդվում։ Մենք կորցնո՞ւմ ենք վերահսկողությունը։

    2025 թվականի հուլիսին հրապարակված «Մտածողական շղթայի մոնիթորինգ. արհեստական ​​ինտելեկտի անվտանգության նոր և փխրուն հնարավորություն» վերնագրով ուսումնասիրությունը մտահոգություն առաջացրեց մշակողների և արհեստական ​​ինտելեկտի փորձագետների շրջանում: Ուսումնասիրությանը իրենց ներդրումն են ունեցել OpenAI-ի, Google DeepMind-ի, Meta-ի և Anthropic-ի ավելի քան 40 հետազոտողներ, այդ թվում՝ այնպիսի ականավոր դեմքեր, ինչպիսիք են Իլյա Սուցկևերը և Նոբելյան մրցանակակիր Ջեֆրի Հինթոնը:

    Աշխատանքը կենտրոնանում է այսպես կոչված դատողության մոդելների վրա, որոնք օգտագործում են ուժեղացված ուսուցում, այդ թվում՝ OpenAI o1-ը: Այս արհեստական ​​բանականության համակարգերը կառուցում են դատողության շղթաներ բնական լեզվով, ինչը տեսականորեն թույլ է տալիս մարդկանց վերահսկել և վերլուծել իրենց «մտածողությունը»: Այնուամենայնիվ, ինչպես նշում են հեղինակները, նեյրոնային ցանցերի դատողությունը կարող է լինել թերի կամ մանիպուլյատիվ, օրինակ՝ դրանք կարող են շահագործել ալգորիթմների խոցելիությունները՝ պարգևը «խաբելու» կամ առաջադրանքը կատարելու ձևացնելու համար:.

    Որոշ դեպքերում, արհեստական ​​բանականությունը ոչ միայն սխալներ է թույլ տալիս, այլև միտումնավոր է վարվում. այն մոդելավորում է կեղծ գործողություններ, անտեսում հրահանգները կամ նույնիսկ հետապնդում է թաքնված նպատակներ: Մեկ օրինակ է OpenAI o3 մոդելի կողմից անջատման հրամանի դիվերսիան և Claude 4 Opus մոդելի կողմից օգտատերերի շանտաժը՝ փոխարինման սպառնալիքին ի պատասխան:.

    Հետազոտողների կարծիքով, ամենամեծ վտանգը մասշտաբավորման մեջ է։ Ավելի արագ արդյունքների հասնելու ճանապարհին մոդելները կարող են հրաժարվել մարդու համար ընթեռնելի լեզվից և կառուցել դատողությունների շղթաներ «թաքնված տարածքում»՝ առանց տեքստային մեկնաբանության։ Սա բարձրացնում է արդյունավետությունը, բայց գործնականում անհնար է դարձնում մոնիթորինգը։.

    Արհեստական ​​բանականության օպտիմալացումը՝ շղթաները կրճատելով կամ որոշակի ձևակերպումներ արգելելով, նվազեցնում է պատասխանների որակը, մինչդեռ մտածողությունը խորացնելու փորձերը հանգեցնում են թափանցիկության կորստի: Մասնագետները զգուշացնում են, որ նման սցենարում մարդիկ կորցնում են համակարգի նկատմամբ վերահսկողությունը:.

    Թեև «Արհեստական ​​բանականություն 2027» նախագծի նման աշխարհի վերջի կանխատեսումները կարող են չափազանցված թվալ, այս հետազոտությունն այլևս գիտաֆանտաստիկա չէ։ Այն ծառայում է որպես նախազգուշացում. առանց հուսալի վերահսկողության մեխանիզմների՝ արհեստական ​​բանականությունը կարող է անվերահսկելի դառնալ։.